從大數據到大模型 現代應用的數據范式演進與數據庫服務新浪潮
在數字經濟的浪潮下,數據的形態、價值和應用范式正在經歷一場深刻的變革。從早期以“海量、高速、多樣”為特征的大數據時代,演進到今天以“智能、生成、驅動”為核心的大模型時代,現代應用對數據的需求和數據處理的方式發生了根本性轉變。這一轉變不僅重塑了技術架構,也催生了數據庫服務的新范式。
一、 范式演進:從數據倉庫到數據智能體
1. 大數據時代:以“存、管、查”為中心
大數據時代的核心是處理和分析海量、多源、異構的數據,以發現歷史規律、進行事后分析。技術棧以Hadoop/Spark生態、數據倉庫(如Hive)、數據湖為核心。數據庫服務的焦點在于存儲的擴展性、批量處理的吞吐量以及復雜的聯機分析處理(OLAP)能力。數據是靜態的“礦產資源”,需要經過復雜的ETL(提取、轉換、加載)流程才能產生價值。
2. 大模型時代:以“理、學、用”為中心
大模型時代,數據不僅是分析的客體,更是驅動智能的主體。范式轉向為:
- 理解(Understanding):數據需要被深層語義理解,而不僅僅是結構化查詢。這要求數據庫能處理非結構化數據(文本、圖像、音視頻),并具備一定的向量化表征和語義檢索能力。
- 學習(Learning):數據直接作為“燃料”注入大模型進行訓練與微調,對數據的質量、規模、時效性和標注提出了前所未有的高要求。數據庫需要支持高效的數據準備、版本管理和流水線供給。
- 應用(Application):大模型作為應用的核心,需要與數據庫深度交互,實現基于自然語言的查詢(Text-to-SQL)、實時決策、內容生成與推理。數據庫從后臺的存儲系統,演變為智能應用的實時“大腦”與“記憶體”。
二、 現代應用的新需求與數據庫服務的挑戰
現代智能應用(如AI客服、個性化推薦、代碼生成、自動駕駛)對數據庫服務提出了全新挑戰:
- 多模數據融合:需同時高效處理結構化表數據、半結構化JSON/圖數據、非結構化文本/向量數據,并能建立它們之間的關聯。
- 實時智能決策:要求數據庫不僅能低延遲地響應查詢,更能支持在線學習、實時特征計算和與模型服務的無縫對接。
- 數據-模型協同:需要管理從原始數據、特征工程、模型訓練到推理部署的全鏈路數據,支持版本化、可追溯和高效回滾。
- 規模與成本:大模型訓練涉及PB級數據,推理需應對高并發請求,如何在保障性能的同時控制成本成為關鍵。
三、 數據庫服務的范式創新
為應對上述挑戰,數據庫服務正在從單一的存儲引擎,向一體化、智能化的數據平臺演進:
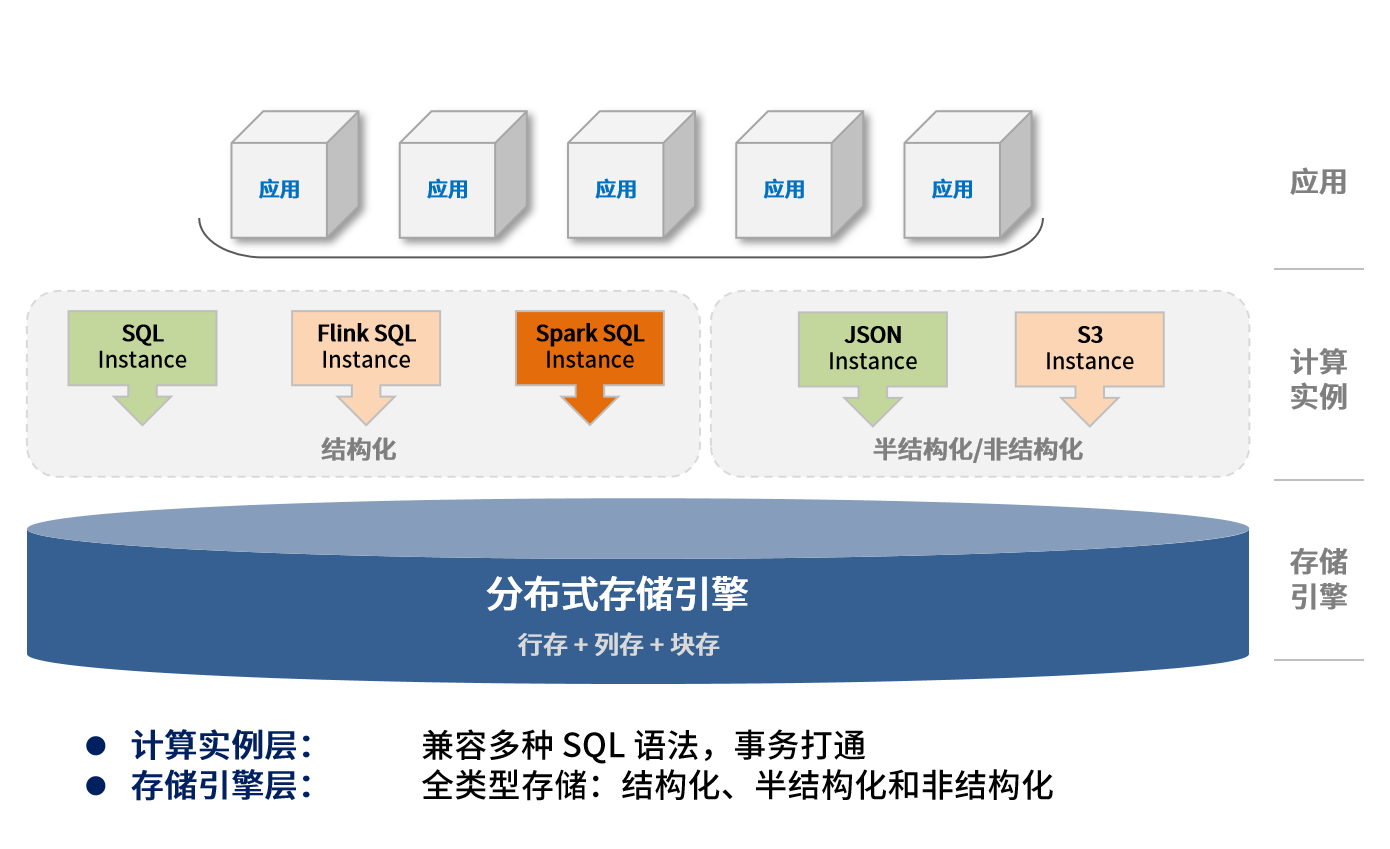
- 統一數據平臺興起:融合事務處理(OLTP)、分析處理(OLAP)、流處理(Streaming)和向量檢索(Vector Search)能力的“湖倉一體”(Lakehouse)或“HTAP”架構成為趨勢。用戶可以在一個平臺上完成從數據接入、治理、分析到服務AI的全流程。
- 向量數據庫成為標配:為高效存儲和檢索大模型所需的嵌入向量,專用向量數據庫(如Milvus, Pinecone)或傳統數據庫的向量擴展(如PgVector, Elasticsearch的向量功能)迅猛發展,支撐著語義搜索、推薦、去重等核心AI場景。
- AI原生數據庫萌芽:下一代數據庫開始將AI能力內化:
- AI for DB:利用機器學習優化數據庫自身,如智能索引、自動調優、異常檢測與預測性運維。
- DB for AI:原生支持AI工作負載,如內置模型推理函數、自動特征存儲與管理、與主流AI框架(PyTorch, TensorFlow)深度集成,提供端到端的AI數據流水線服務。
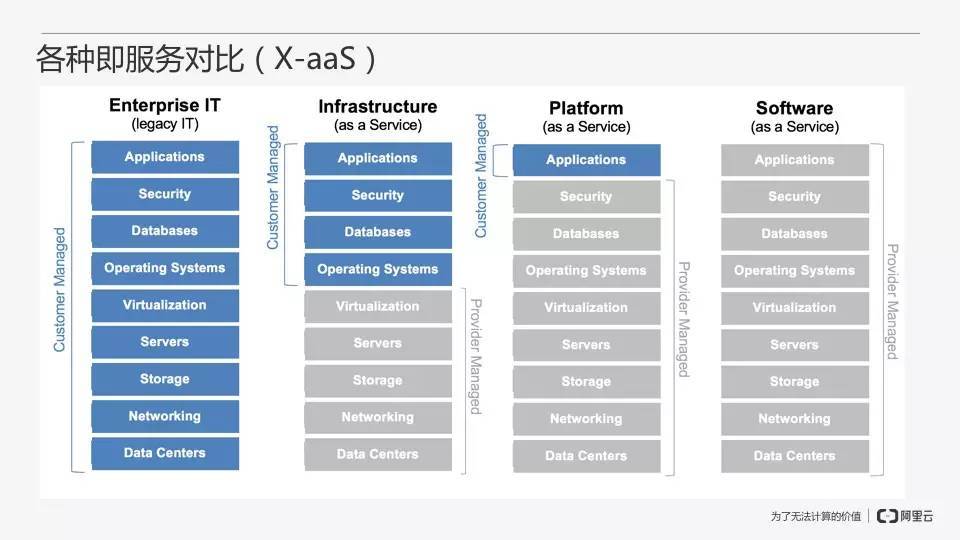
- 服務模式云化與Serverless化:云數據庫服務通過彈性伸縮、按需付費、全球部署和免運維,極大降低了企業使用先進數據技術的門檻。Serverless架構進一步將資源管理細節抽象,讓開發者更專注于業務邏輯和數據價值本身。
四、 展望:數據范式的未來
數據與智能的邊界將越發模糊。數據庫將不再僅僅是“存儲數據的庫”,而會演進為“封裝了數據、處理邏輯與智能的實時服務平臺”。它可能以“數據智能體”的形式存在,能夠理解自然語言指令,自主進行數據探查、關聯分析與洞見生成,并直接驅動應用行為。
數據安全、隱私保護(如聯邦學習支持)、合規性以及在此基礎上的數據資產化流通,將成為數據庫服務必須夯實的基石。
從大數據到大模型,數據范式正從“事后洞察”走向“實時智能驅動”。這場變革推動著數據庫服務不斷突破傳統邊界,向更融合、更智能、更易用的方向演進,為構建下一代智能應用提供核心動力。對于企業和開發者而言,理解并擁抱這一數據范式變遷,是贏得未來競爭的關鍵。
如若轉載,請注明出處:http://m.tinolift.cn/product/8.html
更新時間:2026-11-09 22:17:18